今天是特别快乐的一天。
在已有对Agent的了解下,如何设计并实现一个最小可运行的DB Agent。
首先明确本文讨论的 DB Agent 的功能边界,主要实现Ask和Agent模式:Agent模式开放execute_query来执行DML/DQL,DML需要生产库隔离和一次性授权允许执行;Ask模式负责简单的库、表、字段、时间的只读功能。
- Ask模式:DB Agent对数据库进行只读操作:list_databases,list_tables,get_columns,get_current_time。
- Agent模式:包括只读与写操作在内的的所有tools,写操作tools:execute_query,explain_query以及get_sample_data。
本文讨论的DB Agent不包括对于「通过performance_schema, information_schema、status、variables表」和「主从复制状态」等进行根因分析的高级功能。
核心工具execute_query的思路与实现可以参考:t8y2/dbx;agent-loop的for-loop和工具调用部分可以自己实现,实现思路可以参考 learn-claude-code。
Some QAs
用几个QA明确一下相关概念。
Q:DB Agent的这些功能,需要实现哪些tools?
A:基于mysql Agent模式下的tools有如下几个:
-
只读
- list_databases 列出当前课访问的数据库
- list_tables 列出当前数据库中的表和视图
- get_columns 列出当前表的完整字段定义
- get_current_time 获取当前用户客户端所在时间以及时区对应的utc时间。(和数据库无关)
-
Agent模式的基础tools
-
execute_query:执行 SQL 并返回结果。对于DML和 DDL,需要进行生产库隔离,用户一次性授权后执行。
- 限制mysql执行结果给Agent的返回数量,避免撑爆上下文:并非是在mysql的sql语句中加 `limit 50 / 1000`,而是输出后截断,默认最多返回50行,可以显示在工具调用时设置返回上限。
-
get_sample_data:从指定表采样数据,默认20行最多100行。
-
explain_query 获取只读 SQL 的 MySQL 执行计划,使用
EXPLAIN FORMAT=JSON获取。- explain_query不会在exexcute_query之前自动调用,需要Agent主动触发,比如「帮我看下为什么这个sql执行这么慢」时会调用explain_query。
-
Ask模式下 没有 execute_query、get_sample_data和explain_query这几个读写工具,只支持库、表、字段属性和时间。
Ask模式下的tools实现比较简单,Agent模式下的execute_query使我们今天主要讨论的对象。
Q:用户询问,ai生成后,后端是如何从生成文本中拿到这一条或者多条sql的呢?
A:分几种模式:Agent模式、Ask模式
(1)Agent模式下提问,模型响应后返回工具调用,agent-back执行工具调用(风险分类,读sql直接执行,如果是ddl/dml且非生产库,则进行权限检查,向用户申请一次性授权),后端不是从ai返回文本中抽取sql,而是通过在询问时携带tools声明,规定必须携带一个字符串参数sql。
# execute_query_sql
{
  "name": "execute_query",
  "arguments": {
    "sql": "SELECT * FROM users LIMIT 10"
  }
}
-
模型流式返回工具调用时,后端把分段到达的参数拼起来,解析成 JSON。如果模型一次返回多个工具调用,就得到多个调用对象。
-
Agent 循环逐个处理调用;执行器直接读取
arguments["sql"],然后做 MySQL 风险分类和权限检查。- 如果是单个sql,则按照上面的流程进行。
- 如果一个sql参数中包含多个sql语句,sql risk分类器会做mysql风险分类和权限检查。
(2)Ask模式
用户提问后,模型可能会回复一大堆内容,其中包括sql代码块的,前端会进行展示优化,在点击执行/临时执行时会分别 「创建基于codemirror6的代码query窗口,将sql块中的sql append进行 并执行」或者「直接执行 捕获并展示结果」。
execute_query实现
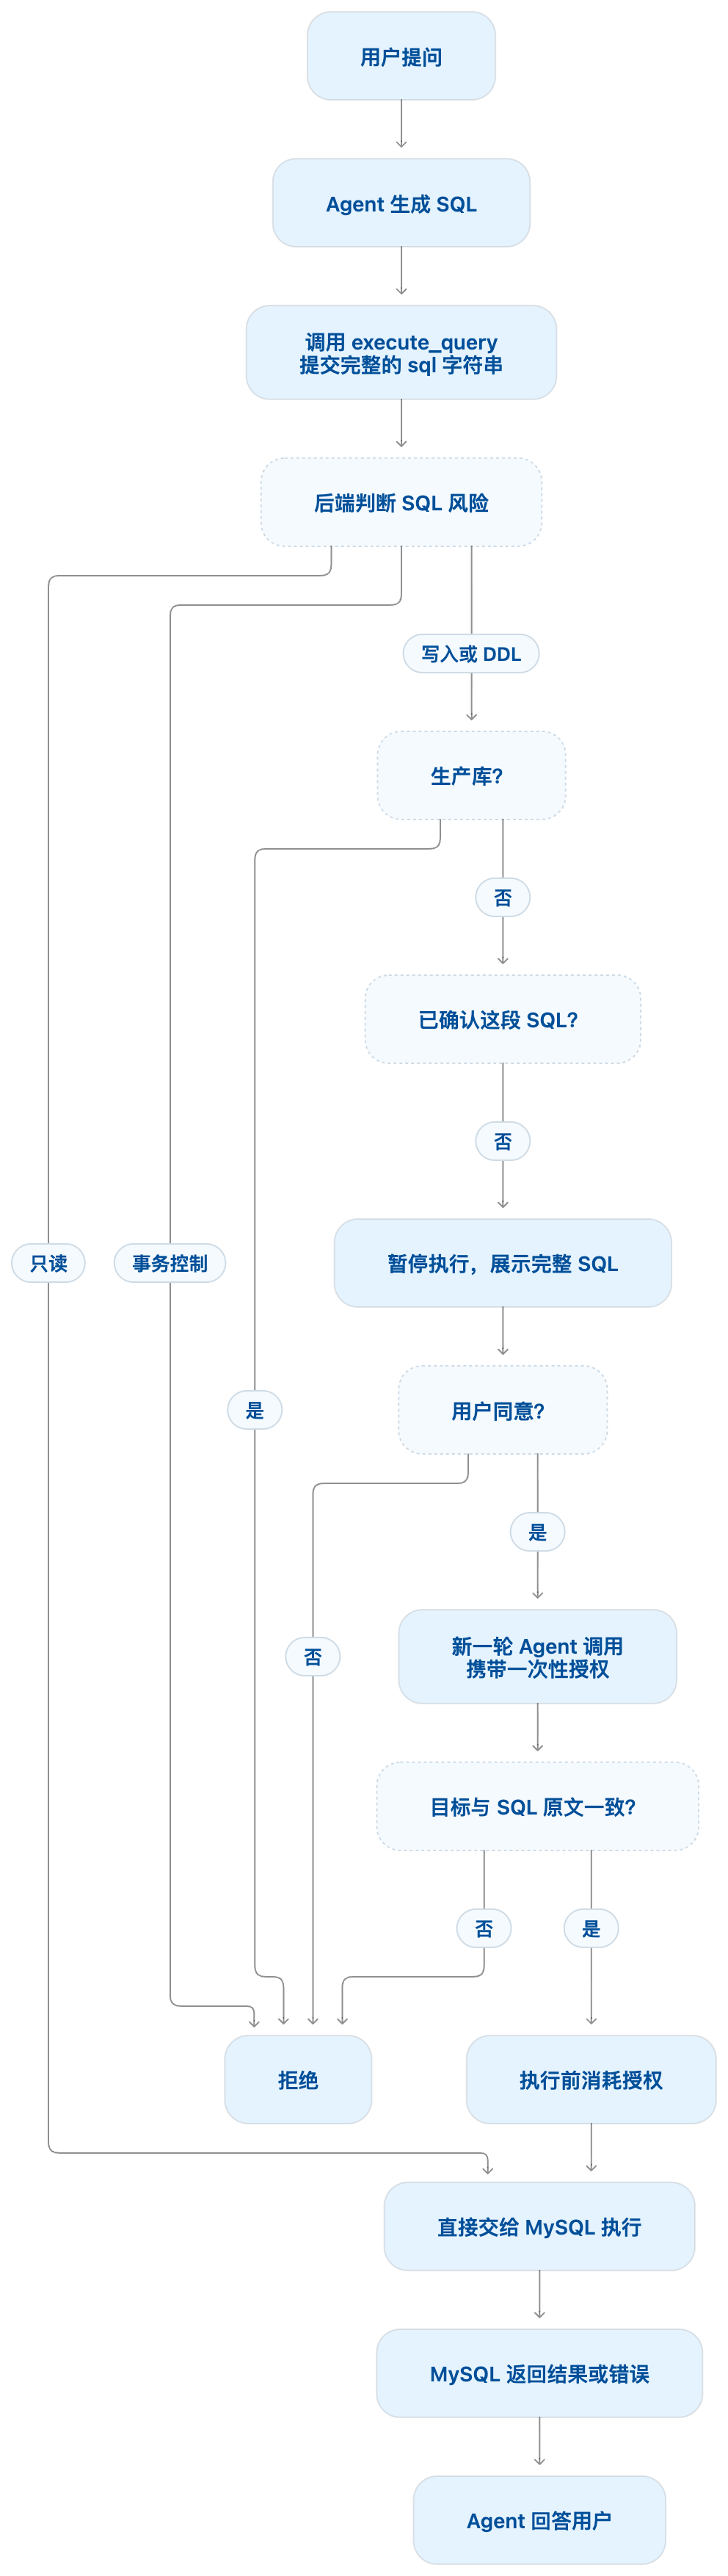
用户提问后,模型返回携带一个sql或者多个sql的execute_query调用json,agent-loop收到后进行execute_query的工具调用,下面是我们最简单的工具流程。
- sql risk分类。
- 如果是非生产库上的DDL/DQL,如果确认缓存中包含则直接执行,如果没有确认过,则携带目标sql申请用户确认并获取一次性授权/会话授权,得到授权后如果是一次性则消耗后执行,如果不是则交给mysql执行层执行,最后将结果返回。
Sql Risk 分类
几种sql risk
sql风险有两种:
- sql对数据库执行什么操作:DDL、DQL、DML,TCL等等。
- 是否是慢sql,性能如何,扫描量、执行成本估计,加锁对其他库的影响。
1、Sql risk 分类
定义如下几个等级,先对sql进行分类
分类器不只看开头的关键字。例如 SELECT ... FOR UPDATE 会加锁,SELECT nextval(...) 会改变序列,某些数据库的 SELECT ... INTO 会创建表;这些会归为 Write。存在多条语句时则取其中最高的风险级别。
| 分类 | 典型语句 | Agent 处理 |
|---|---|---|
| ReadOnly | 普通 SELECT、SHOW、DESCRIBE | 可以执行 |
| Write | INSERT、UPDATE、DELETE、MERGE | 需要用户确认具体 SQL |
| Ddl | CREATE、ALTER、DROP、TRUNCATE、GRANT | 需要用户确认具体 SQL |
| Transaction | BEGIN、COMMIT、ROLLBACK | Agent 禁止执行 |
2、慢sql分析、执行成本估计
注意:这部分功能没有实现,作为未来的扩展点,目前实现最基本的功能。
Agent 可以调用 explain_query 工具 查看 MySQL 的 EXPLAIN,但执行 execute_query 前没有强制先运行 EXPLAIN,也没有“预计扫描超过多少行就拒绝”的阈值。
Agent 执行的sql 默认取50行,最多1000行,但这是限制的返给Agent的数据量,不能保证mysql只扫描这么多行。
如何实现sql分类
对于sql risk 分类没有使用goinception,使用rust/go的sqlParser 以及 python的mysqlDialect 通过构建AST(Abstract Semantic Tree 抽象语法树)解析sql,再由自己的规则做词法分析,最后得到分类。
(1)以select ... for update为例,如何分类?
-
sqlparser将它解析为查询,同时在查询 AST 中记录锁定子句。 -
DBX 检查
query.locks;非空就归入SqlRisk::Write。- DBX 还用词法检查识别
FOR UPDATE、FOR SHARE、LOCK IN SHARE MODE等,以覆盖解析器未完整表达的写法。如果存在for update,表明是当前读,加了next-key lock(记录行锁 or 间隙gap锁),因为上了锁,所以归类为Write。
- DBX 还用词法检查识别
这里的Write是SqlRisk,加了exclusive lock / shared lock的都算SqlRisk-Write。
sqlParser语法检查、手动词法检查,最后得到sql的分类。
(2)另外一种特殊的case:model返回的execute_query的调用的sql中存在多条sql语句。这种情况如何处理?
# execute_query_sql
{
  "name": "execute_query",
  "arguments": {
    "sql": "SELECT * FROM users LIMIT 10; update users set name = 'new_name' where id = 1;"
  }
}
在正常解析路径中,分类器将整个字符串交给Parser@parse_sql,返回多个 Statement,DBX逐条根据statement以及词法匹配获取这些statement的最高风险等级。
比如 SELECT * FROM users LIMIT 10; update users set name = 'new_name' where id = 1; 最后会被分类为 Write。
生产库隔离
生产库和快照库需要分开,不能在生产库上上锁或者执行长事务,导致正常业务DML无法进行。
一次性授权和会话授权
Sql Risk分类后:readonly直接执行,transcation拒绝,非目标生产库的DML/DDL直接执行
-
如果是 ReadOnly,直接进入Mysql查询层复用 connection进行查询。
-
如果是 Transcation事务,则拒绝。
-
如果是DML/DDL
- 目标数据库是生产库,拒绝。
- 目标数据库不是生产库,且用户本会话 / 传入execute_query的一次性授权参数中 授权过完全相同的sql,进入Mysql查询层。
- 目标数据库不是生产库,且用户没有确认过相同的sql,请求用户的授权,不同意则拒绝,同意则重新携带一次性授权参数(包括确认的sql和确认参数)调用execute_query( ack_sql: string, ack: boolean)来重新调用并执行。一次性授权即用即消耗,只有显式请求用户ack后才会调用
execute_query( ack_sql: string, ack: boolean)。
Mysql查询层:每次agent模式调用sql执行时,都会优先查找当前agent conn pool中是否有空闲连接,没有则创建conn并执行。
注意:代码中 授权粒度 是一次execute_query对应的完整sql字符串,不是用分号分隔的每条sql语句。
多条 SQL 的规则:
- 多个工具调用:一个调用处理完再处理下一个。一次确认只能用于其中一个匹配的写入调用。
- 一个调用的
sql参数里有多条语句:整段 SQL 一起展示、一起比对、作为一次授权提交执行;不会按分号逐条消耗授权。
结果返回
默认返回的sql结果,默认最多返回50行,可以有model返回execute_query调用传入limit,最多1000。
设置最多返回行数的原因:让模型决定取哪部分数据,不让过多tool calling result message占用过多上下文。
流程总结
用GPT简单画了个图,实现起来还是比较简单的。