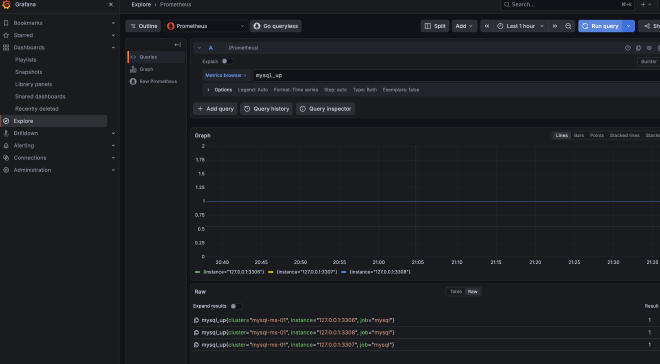
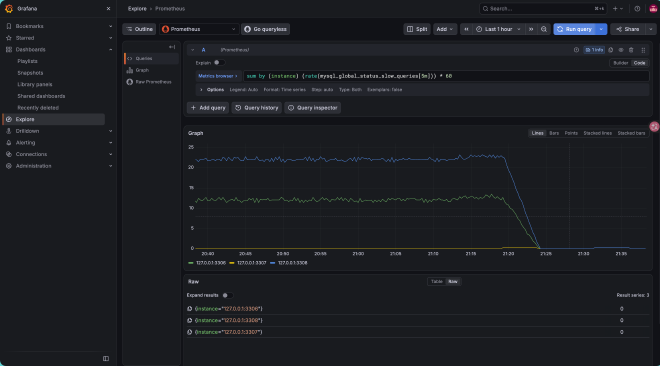
将 基于GTID的一主两从复制集群 接入Prometheus和Grafana。
具体的,在prometheus.yml的target中设置三个mysql实例的地址,通过/probe?target=127.0.0.1:3306~3308交给mysqld-exporter,让mysqld-exporter基于mysql协议,通过多目标模式(multi-target)采集这些mysql实例的status信息。
| 地址 | 部署方式 | |
|---|---|---|
| 一主两从 | 127.0.0.1:3306~3308 | mysql二进制部署,添加service unit来使用systemctl管理 |
| prometheus | 19090 | docker部署,host模式 |
| mysqld-exporter | 9104 | docker部署,host模式 从GTID一主三从中察取数据给prometheus监控管理。 |
| grafana | 13000 | docker部署,host模式 |
compose相关准备 #
slow-query-monitor/
├── README.md
├── .env.example                     # 端口与 Grafana 密码,复制成 .env 后使用
├── .gitignore                       # 排除 .env 和真实的 my.cnf
├── docker-compose.yml               # prometheus + mysqld-exporter + grafana
├── mysqld-exporter/
│   └── my.cnf.example               # exporter 连 MySQL 的凭据,复制成 my.cnf 后填密码
├── grafana/
│   └── provisioning/
│       └── datasources/
│           └── prometheus.yml       # 数据源自动配置,启动即生效,不用在 UI 里手点
├── prometheus/
│   ├── prometheus.yml               # 多目标采集 + 自身采集
│   └── rules/
│       └── mysql-slow.yml           # 慢查询 / 复制延迟 / 复制中断 / 采集失败
├── sql/
│   ├── 01-create-exporter-user.sql  # 在【当前主库】执行
│   └── 02-enable-slow-log.sql       # 三个实例都要执行
└── scripts/
    ├── 00-who-is-master.sh          # 查当前主库(读 orchestrator API)
    └── check-metrics.sh             # 核对指标名真的存在、连通性正常
整体docker-compose
# 慢查询监控栈:Prometheus + mysqld-exporter + Grafana
#
# 三个服务全部使用 host 网络,原因见 README 第四节:
#   1. 容器里的 127.0.0.1 就是宿主机,能直连 bind-address=0.0.0.0 的四个 mysqld;
#   2. 源 IP 是 127.0.0.1,exporter 账号可以收紧成 'exporter'@'127.0.0.1',不必开 '%';
#   3. 这台机器上跑着 mihomo(Clash),桥接网络里的容器会被 fake-ip DNS 坑到,
#      host 网络全程只用 IP,不触发 DNS 解析。
#
# 副作用:端口不走 ports: 映射,而是由各服务命令行的监听参数决定。

name: mysql-slow-monitor

services:
  # ---------------------------------------------------------------- exporter
  # 一个进程覆盖三个 MySQL 实例:靠 mysqld-exporter 的多目标模式,
  # Prometheus 用 /probe?target=127.0.0.1:3306 逐个探,凭据从挂载的 my.cnf 读。
  mysqld-exporter:
    image: prom/mysqld-exporter:v0.20.0
    container_name: mysqld-exporter
    restart: unless-stopped
    network_mode: host
    command:
      - --config.my-cnf=/etc/mysqld_exporter/my.cnf
      - --web.listen-address=:${EXPORTER_PORT:-9104}
      # 下面三个是默认就开的,显式写出来方便看出采集了什么
      - --collect.global_status # Slow_queries 等 SHOW GLOBAL STATUS 计数器,慢查询监控的核心
      - --collect.global_variables # long_query_time 等变量,用于确认配置真的生效了
      - --collect.slave_status # 复制延迟/IO/SQL 线程状态,只在从库上有数据
      # 按需打开的采集器
      - --collect.engine_innodb_status # SHOW ENGINE INNODB STATUS:死锁、history list
      - --collect.binlog_size # binlog 体积,复制健康度
      - --collect.perf_schema.eventsstatements # 慢 SQL digest 下钻,会查 performance_schema
      # - --collect.info_schema.innodb_metrics  # 指标数量很大(数百个),默认不启用
    volumes:
      # 注意:若 my.cnf 不存在,Docker 会把挂载源当成目录自动建出来,
      # 结果是一个名为 my.cnf 的目录,exporter 会以"读不到凭据"的怪错启动失败。
      # 启动前必须先 cp my.cnf.example my.cnf。
      - ./mysqld-exporter/my.cnf:/etc/mysqld_exporter/my.cnf:ro

  # -------------------------------------------------------------- prometheus
  prometheus:
    image: prom/prometheus:v3.15.0
    container_name: prometheus
    restart: unless-stopped
    network_mode: host
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --web.listen-address=:${PROMETHEUS_PORT:-9090}
      - --web.enable-lifecycle # 允许 POST /-/reload 热加载配置和规则
      - --storage.tsdb.retention.time=15d
    volumes:
      - ./prometheus:/etc/prometheus:ro
      # 用命名卷而不是 bind mount:镜像里 /prometheus 的属主是 nobody(65534),
      # 命名卷会继承镜像内目录的属主所以开箱可用;bind mount 到一个 root 属主的
      # 宿主机目录则会以 "permission denied" 反复重启。
      - prometheus-data:/prometheus

  # ----------------------------------------------------------------- grafana
  grafana:
    image: grafana/grafana:13.2.3
    container_name: grafana
    restart: unless-stopped
    network_mode: host
    environment:
      # 3000 被 orchestrator.service 占用,这里必须用别的端口
      - GF_SERVER_HTTP_PORT=${GRAFANA_PORT:-13000}
      - GF_SECURITY_ADMIN_PASSWORD=${GF_ADMIN_PASSWORD:-admin}
      # 传给 grafana/provisioning/datasources/prometheus.yml 里的 ${PROMETHEUS_PORT},
      # 让数据源地址和 Prometheus 实际端口永远一致(Grafana 的 provisioning
      # 文件支持环境变量插值,所以这里是唯一需要维护端口的地方)
      - PROMETHEUS_PORT=${PROMETHEUS_PORT:-9090}
      - TZ=Asia/Shanghai
    volumes:
      - grafana-data:/var/lib/grafana
      # 数据源自动配置。只读挂载,防止容器往里写东西后宿主机上看不出来。
      - ./grafana/provisioning:/etc/grafana/provisioning:ro

volumes:
  prometheus-data:
  grafana-data:
mysqld-exporter #
# my.cnf.exmaple
# mysqld-exporter 的 MySQL 凭据。
# 复制成 my.cnf 后再改:cp mysqld-exporter/my.cnf.example mysqld-exporter/my.cnf
#
# 真实的 my.cnf 已被 .gitignore 排除,只有这个 .example 入库。
#
# 为什么放在这里而不是容器环境变量:
#   本项目用 mysqld-exporter 的"多目标模式",一个 exporter 容器同时服务 3306/3307/3308。
#   多目标模式下凭据从本文件的 [client] 段读取,目标地址由 Prometheus 通过
#   /probe?target=127.0.0.1:3306 传进来,因此不能再用单目标的 DATA_SOURCE_NAME 环境变量。
#
# 密码必须与 sql/01-create-exporter-user.sql 里创建的账号一致。

[client]
user = exporter
password = CHANGE_ME
prometheus #
prometheus/premetheus.yaml
# Prometheus 配置:多目标模式采集三个 MySQL 实例
#
# 两个硬性提醒:
#   1. Prometheus 的配置文件不支持读环境变量。下面标注了「与 .env 保持一致」的
#      两处地址,改 .env 里的端口时必须同步改这里。
#   2. static_configs 里只写地址,绝不写 role: master / role: slave 这类标签 ——
#      这台集群已经切过主(README 第一节),静态角色标签切完就是错的。
#      需要判断主从时,从指标反推:有 mysql_slave_status_* 的就是从库。

global:
  scrape_interval: 30s
  evaluation_interval: 30s
  external_labels:
    cluster: mysql-ms-01

rule_files:
  - /etc/prometheus/rules/*.yml

# 没接 Alertmanager,告警只在 Prometheus 的 /alerts 页面可见。
# 要外发(飞书/钉钉/邮件)时再按 README 第十节扩展。
# alerting:
#   alertmanagers:
#     - static_configs:
#         - targets: ['127.0.0.1:9093']

scrape_configs:
  - job_name: prometheus
    static_configs:
      # 【必须与 .env 的 PROMETHEUS_PORT 一致】Prometheus 的配置文件不支持读环境变量,
      # 所以改端口时这里必须手改——这是本方案唯一需要"改两处"的地方。
      # 当前 19090:本机 mihomo(Clash)占着 Prometheus 的出厂默认端口 9090。
      #
      # 写错的症状很隐蔽,记一下:target 状态显示 down、lastError 是
      # "server returned HTTP status 404 Not Found"——因为你其实采到 mihomo 上了,
      # 它的 external-controller 在 9090,/metrics 是 404。
      # 这个 job 只采 Prometheus 自己的运行指标,挂了不影响 mysql 那三个 target,
      # 所以很容易一直没发现。
      - targets: ['127.0.0.1:19090']

  - job_name: mysql
    scrape_interval: 15s
    # 多目标模式:每个 target 都去 exporter 的 /probe 端点探,而不是各自的 /metrics
    metrics_path: /probe
    params:
      # 对应 mysqld-exporter 挂载的 my.cnf 里的 [client] 段;
      # 不写这个参数时默认值也是 client,写出来是为了自解释。
      auth_module: [client]
    static_configs:
      - targets:
          - 127.0.0.1:3306
          - 127.0.0.1:3307
          - 127.0.0.1:3308
        labels:
          cluster: mysql-ms-01
    relabel_configs:
      # 把 target 地址搬到 /probe 的 target 查询参数里
      - source_labels: [__address__]
        target_label: __param_target
      # 让 instance 标签显示成被监控的 MySQL 地址,而不是 exporter 的地址
      - source_labels: [__param_target]
        target_label: instance
      # 真正的抓取地址统一指向 exporter 自己。
      # 与 .env 的 EXPORTER_PORT 保持一致。
      - target_label: __address__
        replacement: 127.0.0.1:9104
rules: rules/mysql-slow.yml
# MySQL 慢查询与复制告警规则
#
# 指标名的出处(都已核实,不是凭印象写的):
#   mysql_global_status_slow_queries        来自 SHOW GLOBAL STATUS,值是"本实例启动
#                                           至今的慢查询总数",是个只增不减的计数器
#   mysql_global_status_questions           同上,总查询数
#   mysql_slave_status_<列名小写>           由 BuildFQName("mysql", "slave_status", 列名)
#                                           生成,即 SHOW SLAVE STATUS 的每一列
#   mysql_global_variables_long_query_time  来自 SHOW GLOBAL VARIABLES,用来核对阈值
#
# 两个容易踩的坑:
#   1. Slow_queries 计数器与慢查询日志开关无关,超过 long_query_time 就递增。
#      如果这里一直是 0,先查 long_query_time 是不是还停在默认的 10 秒。
#   2. mysql_slave_status_* 只在【从库】上有序列(主库 SHOW SLAVE STATUS 返回空)。
#      副本停止复制时 Seconds_Behind_Master 是 NULL,该指标直接消失而不是变成 0,
#      所以"复制断了"靠 IO/SQL 线程那两条规则抓,不要指望延迟规则能兜住。

groups:
  - name: mysql-slow-query
    rules:
      - alert: MySQL慢查询占比偏高
        # 慢查询速率 / 总查询速率。绝对值会随业务量波动,占比更能说明"变慢了",
        # 而不是"流量涨了"。clamp_min 防止 0 查询时除零。
        expr: >-
          sum by (instance) (rate(mysql_global_status_slow_queries[5m]))
          / clamp_min(sum by (instance) (rate(mysql_global_status_questions[5m])), 1) > 0.01
		for: 10m
        labels:
          severity: info
        annotations:
          summary: '实例 {{ $labels.instance }} 慢查询占比超过 1%'
          description: >-
            最近 5 分钟慢查询占总查询的 {{ printf "%.2f" $value }}%,
            通常说明执行计划或数据分布变了,而不是流量上涨。

      - alert: MySQL实例采集失败
        # up == 0 表示 Prometheus 这次没抓到:exporter 挂了 / MySQL 连不上 / 认证失效。
        # 这条同时也是"实例本身挂了"的兜底。
        expr: up{job="mysql"} == 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: 'MySQL 实例 {{ $labels.instance }} 指标采集失败'
          description: >-
            连续 2 分钟抓不到 {{ $labels.instance }} 的指标。依次排查:
            mysqld-exporter 容器是否在跑、exporter 账号密码是否与
            mysqld-exporter/my.cnf 里的一致、该 mysqld 是否还在监听。
MySQL慢查询占比偏高
  - name: mysql-slow-query
    rules:
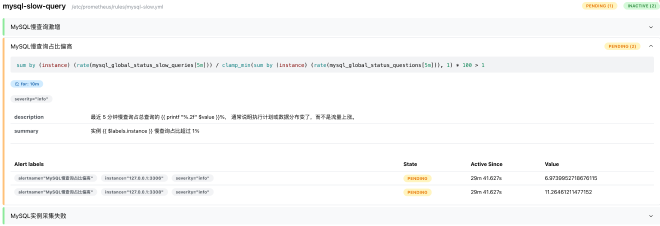
      - alert: MySQL慢查询占比偏高
        # 慢查询速率 / 总查询速率。绝对值会随业务量波动,占比更能说明"变慢了",
        # 而不是"流量涨了"。clamp_min 防止 0 查询时除零。
        expr: >-
		  #  ${value} 取值是 比较符号左侧的值。
		  # 设置3的原因是,默认低流量的情况下,1%就是默认慢查询数量。
          sum by (instance) (rate(mysql_global_status_slow_queries[5m]))
          / clamp_min(sum by (instance) (rate(mysql_global_status_questions[5m])), 1) * 100 > 3
		for: 10m
        labels:
          severity: info
        annotations:
          summary: '实例 {{ $labels.instance }} 慢查询占比超过 2%'
          description: >-
            最近 5 分钟慢查询占总查询的 {{ printf "%.2f" $value }}%,
            通常说明执行计划或数据分布变了,而不是流量上涨。
-
指标
mysql_global_status_slow_queries,Mysql执行的慢查询条数mysql_global_status_questions,mysql执行客户端语句数量
rate(mysql_global_status_slow_queries[5m]: 最近5min每秒增加多少慢查询
sum by (instance) (rate(mysql_global_status_slow_queries[5m])) 逐实例计算

clamp_min(sum by (instance) (rate(mysql_global_status_questions[5m])), 1)
# 如果questions_rate<1, 强行当做1,,

进入mysql实例查看
SHOW GLOBAL STATUS LIKE 'Slow_queries';
SHOW GLOBAL STATUS LIKE 'Questions';
# 236 / 345600,
# 1s 后 变成 239 / 345690
- 在无业务流量的情况下,主要的慢查询都是mysqld-exporter产生的,可以让mysqld-exporter产生的查询不计入慢查询。使用
SET SESSION long_query_time = 60;来调高记录慢查询的门限。 -
grafana/provisioning #
数据源自动配置,启动即生效,不用在grafana的explore中手动输入promql
datasources/prometheus
# Grafana 数据源自动配置(provisioning)
#
# 放在这个目录里,Grafana 启动时会自己读,不用在 UI 里手点。
# 相比手点的好处:
#   - 换台机器照搬这个目录就能复现,不依赖"我记得当时点过什么"
#   - URL 不会手抖打错(手点最容易把 http:// 写成 https:// 或者漏端口)
#   - timeInterval 这种容易被忽略但影响出图质量的设置,写死在文件里
#
# 官方文档:https://grafana.com/docs/grafana/latest/administration/provisioning/

apiVersion: 1

datasources:
  - name: Prometheus
    type: prometheus
    # access: proxy = 由 Grafana 后端去请求 Prometheus(UI 里叫 Server access)。
    # Prometheus 数据源只支持这一种。
    access: proxy
    # host 网络下,容器里的 127.0.0.1 就是宿主机,所以这就是宿主机的 Prometheus。
    # ${PROMETHEUS_PORT} 由 docker-compose.yml 里 grafana 服务的 environment 传进来,
    # 值来自 .env —— 改了端口不用动这个文件。
    url: http://127.0.0.1:${PROMETHEUS_PORT}
    # 固定 uid。导入社区看板时,看板是按 uid 引用数据源的,
    # 不固定的话每次重建数据源 uid 都会变,看板就"找不到数据源"了。
    uid: prometheus
    isDefault: true
    # 设 false 是为了防止有人在 UI 里改了设置,却以为 provisioning 文件还在生效
    editable: false
    jsonData:
      # 必须和 prometheus.yml 里的 scrape_interval 一致(15s)。
      # 不设的话 Grafana 可能按比采集间隔更细的步长去查询,
      # 结果是图上出现锯齿状或空洞——数据本身没问题,是查询步长的问题。
      timeInterval: 15s
      httpMethod: POST
      prometheusType: Prometheus
dashboards里面的可以自己写,这里我就不post了。
docker部署 #
设置三个mysql实例的别名,方便进入mysql client管理:
alias mysql3306='/usr/local/mysql/bin/mysql -uroot -h127.0.0.1 -P3306 -pb617@cumt'
alias mysql3307='/usr/local/mysql/bin/mysql -uroot -h127.0.0.1 -P3307 -pb617@cumt'
alias mysql3308='/usr/local/mysql/bin/mysql -uroot -h127.0.0.1 -P3308 -pb617@cumt'
1、在主库上创建exporter账号
-- 01-create-exporter-user.sql
-- 创建 mysqld-exporter 使用的监控账号
--
-- 在【当前主库】上执行,不要在每个实例上都建。
-- 3306/3307/3308 里有两个是 super_read_only,直接在只读实例上 CREATE USER 会被拒绝:
--   ERROR 1290 (HY000): The MySQL server is running with the --super-read-only option
-- 这个账号和授权会通过 GTID 复制自动下发到另外两个实例,无需手工同步。
--
-- 先执行 scripts/00-who-is-master.sh 确认当前主库是哪个端口 —— 这台集群切过主,
-- 不要凭印象认定。当前是 3306:
--   mysql -h127.0.0.1 -P3306 -uroot -p < sql/01-create-exporter-user.sql

-- 密码要和 mysqld-exporter/my.cnf 里的 password 完全一致。
-- 用默认的 caching_sha2_password(MySQL 8.0 的默认插件),
-- mysqld-exporter v0.20.0 内置的 go-sql-driver 支持它,不必改回 mysql_native_password
-- (那个插件在 8.0.34 起已废弃、8.4 起默认关闭)。
CREATE USER IF NOT EXISTS 'exporter'@'127.0.0.1' IDENTIFIED BY 'CHANGE_ME_Exporter@2026';

-- 三个权限各自的用途:
--   PROCESS            SHOW ENGINE INNODB STATUS / SHOW PROCESSLIST
--   REPLICATION CLIENT SHOW REPLICA STATUS(复制延迟和线程状态)
--   SELECT            读 performance_schema / information_schema 做下钻
-- SELECT ON *.* 已经覆盖 performance_schema,不需要再单独授权。
GRANT PROCESS, REPLICATION CLIENT, SELECT ON *.* TO 'exporter'@'127.0.0.1';

FLUSH PRIVILEGES;

-- 验证:确认账号存在且插件正确
SELECT user, host, plugin FROM mysql.user WHERE user = 'exporter';
SHOW GRANTS FOR 'exporter'@'127.0.0.1';
创建成功
 mysql3306 < 01-create-exporter-user.sql
mysql: [Warning] Using a password on the command line interface can be insecure.
user    host    plugin
exporter        127.0.0.1       caching_sha2_password
Grants for exporter@127.0.0.1
GRANT SELECT, PROCESS, REPLICATION CLIENT ON *.* TO `exporter`@`127.0.0.1`
2、三个实例开慢查询
使用set persist持久化到数据库中。
for p in 3306 3307 3308; do
  echo "===== $p ====="
  mysql -h127.0.0.1 -P$p -uroot -p < sql/02-enable-slow-log.sql
done
三个实例都需要处理一遍
不然从库上就没有自己的慢查询了。
set persist 不会进binlog,所有不会复制到从库上。
set persist写的是实例自己的datadir下面的mysqd-auto.cnf。
sql/02-enable-slow-log.sql
-- 打开慢查询统计
--
-- 【三个实例都要执行】—— 这是实例级参数,不会通过复制下发。
--   for p in 3306 3307 3308; do
--     mysql -h127.0.0.1 -P$p -uroot -p < sql/02-enable-slow-log.sql
--   done
--
-- 为什么用 SET PERSIST 而不是 SET GLOBAL、也不是改 /etc/my*.cnf:
--
--   SET GLOBAL   立即生效,但重启后丢失,回到默认的 10 秒。
--   改 my.cnf    最规范,但要重启 mysqld。这台机器上 orchestrator 在跑,
--                重启主库会触发一次自动切换;而且 3306 的 cnf 里硬编码了
--                read_only=1,重启后它会以只读身份回来,集群会在没有可写主库的
--                状态下等 orchestrator 救场。所以能不动重启就不动。
--   SET PERSIST  立即生效 + 写进 datadir 下的 mysqld-auto.cnf,重启不丢,
--                而且下次故障切换、被提升为主库的实例依然带着这套配置。
--
-- 关于只读实例:3306/3307/3308 里的从库是 super_read_only。服务器只读模式挡的是
-- 普通表的写入,SET PERSIST 写的是配置文件,不受影响;文档里那类
-- "ERROR 1238 ... is a read only variable" 说的是 version/log_bin 这种
-- 【只读变量】,和服务器只读模式是两回事。下面三个都是动态变量。

-- 慢查询判定阈值,单位秒,支持小数。默认 10 秒,对绝大多数业务来说太宽松了。
-- 这里取 0.1 秒(和 prometheus-examples 示例一致)。生产环境按自己的 SLA 定,
-- 通常 0.1 ~ 1 秒。
SET PERSIST long_query_time = 0.1;

-- 打开慢查询日志。
-- 注意:Slow_queries 这个计数器跟日志开关无关,超过 long_query_time 就递增;
-- 开日志是为了能下钻看到【具体的 SQL 文本】。
SET PERSIST slow_query_log = ON;

-- 输出到文件。不用 TABLE 的原因:往 mysql.slow_log 表里写,在只读从库上更别扭,
-- 而且表写满还要自己清理;文件方式由 logrotate / purge 处理更省心。
SET PERSIST log_output = 'FILE';

-- 保持关闭(默认就是 OFF)。打开后会把"没走索引"的查询也计入慢查询,
-- 计数器会被灌爆,告警形同虚设。需要查这类问题时临时开、用完关。
-- SET PERSIST log_queries_not_using_indexes = OFF;

-- 保持关闭(默认 OFF)。它控制的是"从库回放主库 binlog 的语句要不要写慢日志",
-- 关着才不会把主库已经记过的慢查询在从库上再记一遍。
-- SET PERSIST log_slow_replica_statements = OFF;

-- ---------------------------------------------------------------- 验证
-- 1) 这三个变量当前值(期望 0.1 / ON / FILE)
SHOW GLOBAL VARIABLES WHERE Variable_name IN
  ('long_query_time', 'slow_query_log', 'log_output', 'slow_query_log_file');

-- 2) 确认真的持久化了(应该在结果里看到上面三个变量)
SELECT * FROM performance_schema.persisted_variables;

-- 3) 计数器确实在动:跑一条必然超阈值的查询,
--    然后看 Slow_queries 是否 +1(这是 rate/increase 计算的原始指标)
SELECT SLEEP(1);
SHOW GLOBAL STATUS LIKE 'Slow_queries';
3、准备.env和my.cnf
cp .env.example .env
cp mysqld-exporter/my.cnf.example mysqld-exporter/my.cnf
vi mysqld-exporter/my.cnf    # 填 ③ 里的密码
vi .env                      # 填 GF_ADMIN_PASSWORD
4、拉取镜像
docker compose pull
docker images | grep -E 'prometheus|mysqld-exporter|grafana'   # 三个都在了才算好
5、启动并验证
docker compose up -d
bash scripts/check-metrics.sh          # 核对指标名 + 三实例连通性
curl -s 'http://127.0.0.1:9090/-/ready'
然后浏览器开 http://127.0.0.1:9090/targets,4 个 target 全 UP 就成了
监控慢sql和主从延迟 #
总之看起来是比直接使用pt-query-digest或者直接看slow.log来的舒服,更不用提还可以配置自动告警了。
Prometheus #
http://aios:19090/alerts
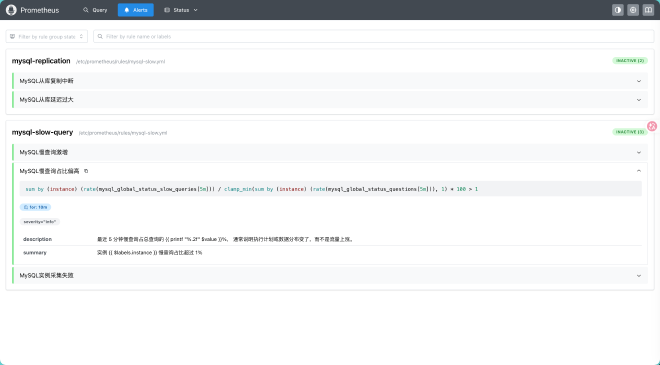
警告时:
Grafana #
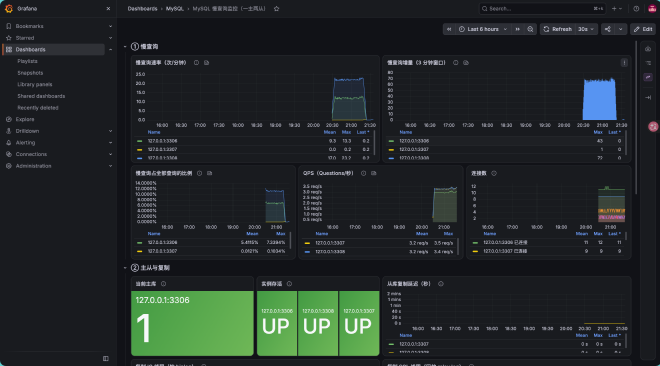
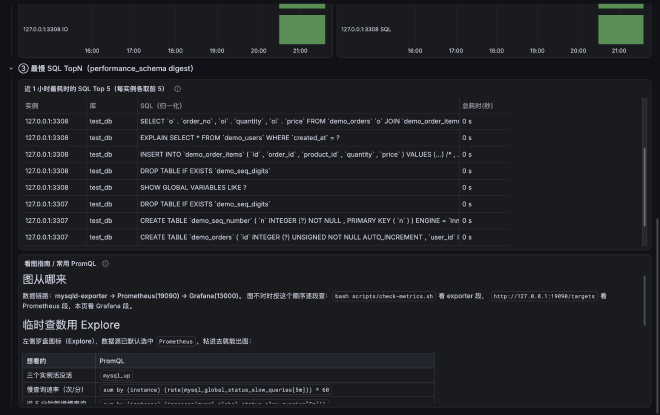
监控慢sql速率、增量、占比,QPS、主从up状态,主从延迟,最慢sql等等。
写PromQL